

転職サービス
レバテックキャリア
MLエンジニアの求人案件が充実しており、Pythonエンジニアからの転向キャリアパスをよく理解したアドバイザーが在籍している
※ サービス選びの参考情報。利用は各自の判断で。
Pythonバックエンドエンジニア → MLエンジニア
FinTechスタートアップに新卒入社してから3年間、PythonとFastAPIを中心にバックエンドAPI開発に従事。MySQLの設計・チューニング、RedisやCeleryを使った非同期処理の実装、Docker/Docker Composeによる開発環境構築の経験を積んできた。コードの品質意識が高く、ユニットテストの整備やCI/CDパイプライン構築も自ら率先して行う習慣がある。社内でアンチフロード機能の要件定義が始まったとき、機械学習モデルを本番環境にデプロイするMLエンジニアの役割に強い関心を持ち始めた。大学時代に機械学習の授業を受けた程度の知識しかないが、Pythonエンジニアとしての実装力を活かして、モデルのサービング・モニタリング・パイプライン自動化を担えるMLエンジニアに転向したいと考えている。
「バックエンドエンジニアとして培ったPython実装力・コード品質意識・コンテナ技術を土台に、機械学習モデルを実際のサービスで稼働させるMLエンジニアへとステップアップしたい。MLOpsの設計から運用まで一貫して担えるエンジニアになることで、AIを活用したプロダクトの価値を最大化することが目標だ。」
上田 健太さん本人の学習設計の語り
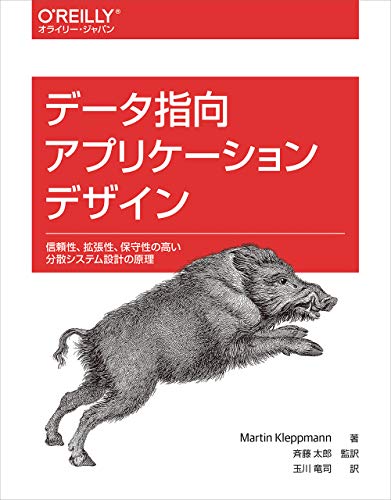
まずAIと機械学習の全体像を俯瞰的に理解し、MLエンジニアとデータサイエンティストの役割分担を明確にする。「データ指向アプリケーションデザイン」でデータパイプラインの設計思想を学び、モデルの学習データ基盤の重要性を理解する。第1フェーズでAWS上でのMLサービス(SageMaker等)の概念を掴みつつ、KubernetesベースのMLワークロード管理を学ぶ。第2フェーズではGitHub ActionsによるCI/CDとMLOpsパイプラインを組み合わせた本番運用の実践力を身につけ、モデルの継続的デリバリーを設計できるMLエンジニアを目指す。
現在のスキル水準とMLエンジニアに必要な水準を並べ、何を伸ばすべきかを可視化しています。
迷ったらこの順番で読むのが推奨。基礎 → 実践 → 視座を上げる、という流れで構成されています。
なぜこの本か
MLパイプラインの上流にある特徴量ストアやデータ基盤の設計を学ぶ上で不可欠。バックエンド設計経験と組み合わせることで、MLシステム全体のアーキテクチャ設計力が身につく。
なぜこの本か
現職でDockerを使っているが、Kubernetesを用いたMLモデルのスケーラブルなサービング環境構築を学ぶ。コンテナ化されたMLワークロードの管理を実践的に習得できる。
機械学習の全体像とMLエンジニアの役割、データパイプライン設計、AWSとKubernetesでのMLワークロード管理
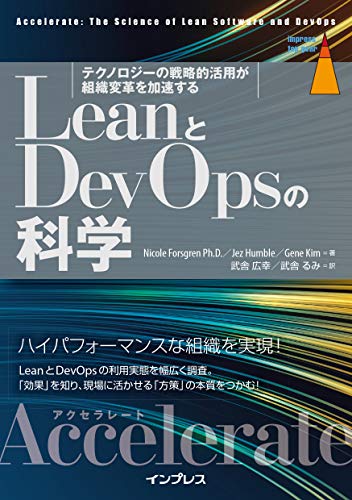
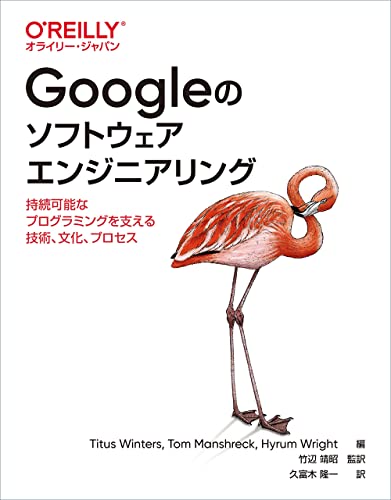
CI/CDによるモデルデプロイ自動化、DevOps文化のML領域への適用、ソフトウェアエンジニアリングのベストプラクティス
このキャリア遷移を目指す上田 健太さんが活用を検討しやすい転職サービスをまとめました。
MLエンジニアの求人案件が充実しており、Pythonエンジニアからの転向キャリアパスをよく理解したアドバイザーが在籍している
※ サービス選びの参考情報。利用は各自の判断で。
AIスタートアップや大手テック企業のMLエンジニア求人を多く保有し、20代のキャリアチェンジ支援に実績がある
※ サービス選びの参考情報。利用は各自の判断で。
同じ職種・近いレベル感を目指す他のペルソナです。学習プランや読む順番のバリエーションとして参考にしてください。
上田 健太さんの学習プランは「機械学習エンジニア」を目指す一例です。 職種全体のロードマップ・必要スキル・代表的な書籍は専用ページで体系的に確認できます。
機械学習エンジニアのロードマップを見る →
